مدل استدلالی یا معمولی؟ آزمون عملی با DeepSeek R1
مدل استدلالی را با حدس انتخاب نکنید. آزمونی بیستنمونهای که روی دادهی خودتان اجرا میکنید و سه عدد میدهد: دقت، زمان و هزینه. با کد Python و قاعدهٔ تصمیم.
مدل استدلالی یا معمولی را با حدس انتخاب نکنید، با یک آزمون بیستنمونهای انتخاب کنید. مقایسههای آنلاین DeepSeek R1 بیشتر انگلیسی و مربوط به ماههای اول عرضهاند و روی کار شما چیزی نمیگویند. این راهنما آزمونی میدهد که خودتان روی دادهی خودتان اجرا میکنید.
تفاوت در یک جمله
مدل استدلالی پیش از جواب، مسئله را برای خودش باز میکند. نتیجه: در مسئلههای چندمرحلهای کمتر میلغزد، ولی دیرتر جواب میدهد و بابت فکرکردنش هم پول میگیرد. توکنهای استدلال در صورتحساب بهعنوان توکن خروجی حساب میشوند، حتی بخشی که به پاسخ نهایی نمیرسد.
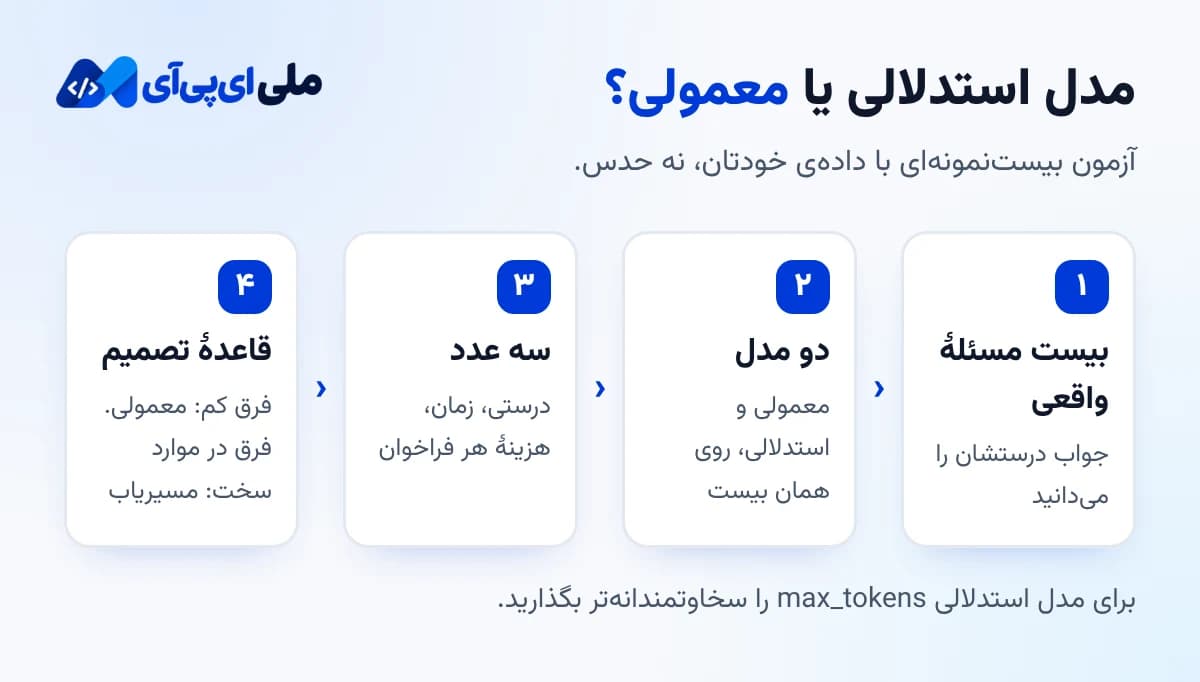
آزمون بیستنمونهای
- بیست مسئلهٔ واقعی از کار خودتان بردارید که جواب درستش را میدانید. حتماً از سختترینها بگذارید.
- همان بیست مسئله را به یک مدل معمولی، مثل DeepSeek V3.2، و به R1 بدهید.
- برای هر فراخوان سه عدد ثبت کنید: درست یا غلط، زمان پاسخ، و
billing.amountRial. - سه ستون را برای هر دو مدل جمع بزنید.
import os, time, requests

URL = "https://melliapi.net/api/v1/ai/chat/completions/"

def run(model, question, max_tokens):
    t = time.time()
    r = requests.post(
        URL,
        headers={"Authorization": "Bearer " + os.environ["MELLIAPI_API_KEY"]},
        json={
            "model": model,
            "max_tokens": max_tokens,
            "messages": [{"role": "user", "content": question}],
        },
        timeout=300,
    )
    data = r.json()
    seconds = time.time() - t
    if not data.get("ok"):
        return None, seconds, 0
    return data["content"], seconds, data["billing"]["amountRial"]
برای R1 max_tokens را سخاوتمندانهتر بگذارید: اگر پاسخ وسط استدلال قطع شود، هزینهٔ توکنها را دادهاید و جوابی ندارید. مهلت اتصال را هم بلند بگیرید.
چطور نتیجه را بخوانید
- اگر دو مدل در دقت فرق چندانی نداشتند، مدل معمولی را بردارید: ارزانتر و سریعتر است.
- اگر R1 در موارد سخت واضحاً بهتر بود، ولی فقط در بخش کوچکی از ورودیها، یک مسیریاب ساده بسازید: مسئلههای ساده به مدل معمولی، مسئلههای سخت به R1.
- اگر زمان برای کاربر مهم است (گفتوگوی زنده)، حتی دقت بهتر R1 شاید ارزشش را نداشته باشد. استدلال برای کاری که در پسزمینه اجرا میشود مناسبتر است.
کجا R1 معمولاً ارزش دارد و کجا نه
مسئلهٔ محاسباتی، پیداکردن باگ در منطقی که بهظاهر درست است و سؤالی که جوابش از ترکیب چند قاعده درمیآید، از جاهایی است که امتحانش میارزد. پاسخ سؤال ساده، دستهبندی و خلاصهسازی جای آن نیست؛ آنجا بابت فکرکردنی که لازم نبوده پول میدهید. اینها نقطهٔ شروع آزموناند، نه حکم: نتیجهٔ نهایی را همان بیست نمونه تعیین میکند.
آنچه این آزمون انجام نمیدهد
- با بیست نمونه آمار نمیسازد. برای تصمیمهای بزرگ نمونهٔ بیشتر بگیرید. بیست نمونه فقط جهت را نشان میدهد.
- عدد زمان و هزینهی دیگران را نمیدهد. عددها از دادهٔ شما درمیآیند و با کار دیگری فرق میکنند.
پرسش و تجربه کاربران
اگر این راهنما جوابتان را نداد، همینجا بپرسید. پرسشها را تیمملی ایپیآی پاسخ میدهد و هر نظر پیش از انتشار بررسی میشود.
هنوز پرسشی ثبت نشده، اولین نفر باشید.