دستهبندی متن فارسی با GPT-5.4 mini
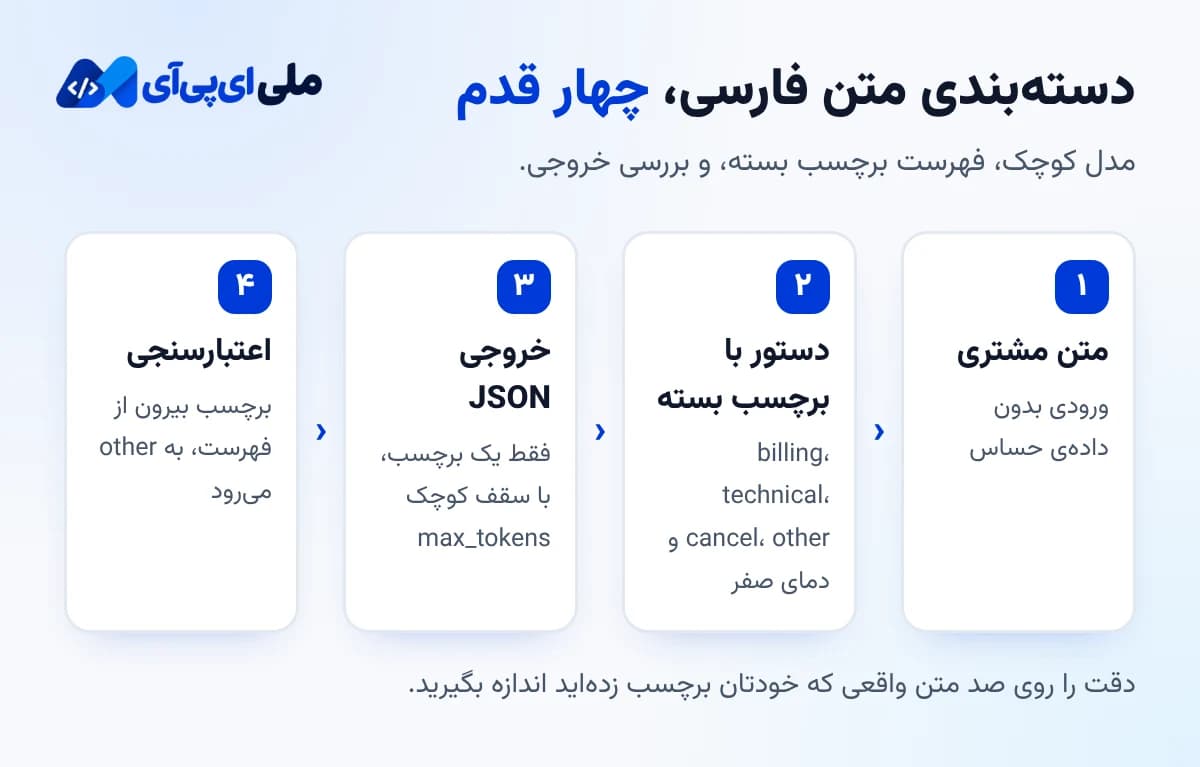
برای دستهبندی متن فارسی مدل کوچک کافی است: فهرست برچسب بسته، دمای صفر و خروجی JSON. این راهنما با نمونه کد میسازد و روش سنجش دقت روی صد متن واقعی را میگوید.
برای دستهبندی متن فارسی لازم نیست سراغ مدل بزرگ بروید: مدل کوچک با فهرست برچسب بسته، دمای صفر و خروجی JSON همین کار را ارزان و سریع انجام میدهد. این راهنما با GPT-5.4 mini یک دستهبندی کامل میسازد، از دستور تا سنجش دقت.
فهرست برچسب را ببندید
مدلی که آزاد برچسب بسازد، برای هر متن اسمی تازه میگذارد و شمارشها از دستتان درمیرود. فهرست را در دستور بنویسید و یک برچسب «سایر» هم بگذارید تا متن نامربوط بهزور در یکی از دستهها نیفتد.
import json, os, requests
URL = "https://melliapi.net/api/v1/ai/chat/completions/"
LABELS = ["billing", "technical", "cancel", "other"]
SYSTEM = (
"متن مشتری را فقط در یکی از این برچسبها بگذار: "
+ ", ".join(LABELS)
+ ". خروجی فقط JSON باشد: {\"label\": \"...\"}. "
"اگر هیچکدام نمیخورد، other."
)
def classify(text):
r = requests.post(
URL,
headers={"Authorization": "Bearer " + os.environ["MELLIAPI_API_KEY"]},
json={
"model": "openai-gpt-5.4-mini",
"max_tokens": 30,
"temperature": 0,
"messages": [
{"role": "system", "content": SYSTEM},
{"role": "user", "content": text},
],
},
timeout=60,
)
data = r.json()
if not data.get("ok"):
raise RuntimeError(data["error"]["code"])
label = json.loads(data["content"])["label"]
return label if label in LABELS else "other"سه تصمیم در این کد هست:
temperatureصفر: برای دستهبندی تنوع نمیخواهید، ثبات میخواهید. همان متن باید هر بار همان برچسب را بگیرد.max_tokensکوچک: خروجی چند کلمه است. سقف کوچک یعنی رزرو کوچک و فراخوان موازی بیشتر.- اعتبارسنجی برچسب: اگر مدل چیزی بیرون از فهرست گفت، آن را رد کنید و به «other» ببرید. خروجی مدل ورودی قابل اعتماد برنامهٔ شما نیست.
دقت را اندازه بگیرید، حدس نزنید
صد متن واقعی از کار خودتان بردارید و خودتان برچسب بزنید. بعد همان صد متن را از مدل رد کنید و درصد تطابق را حساب کنید. جاهایی که اشتباه کرده را بخوانید: معمولاً یا دو برچسب شما واقعاً همپوشاناند، یا توضیح برچسب در دستور مبهم است. هر دو را با اصلاح دستور یا ادغام برچسبها درست میکنید، نه با مدل گرانتر.
اگر دقت هنوز کم بود، آنوقت یک مدل بزرگتر را روی همین صد متن امتحان کنید و تفاوت را با هزینهاش بسنجید.
ترافیک بالا را مدیریت کنید
سقف هر کلید ۶۰ فراخوان در دقیقه است. برای هزاران متن، فراخوانها را با یک صف و سرعت ثابت بفرستید و برای پاسخ rate_limited از هدر Retry-After استفاده کنید، نه تلاش مجدد فوری. کدهای خطا در مستندات آمده است.
آنچه این روش انجام نمیدهد
- عملکرد روی لهجه و عامیانه تضمین نیست. منابعی که دیدم دربارهٔ دقت این مدل روی متن فارسی عدد ندادهاند، پس عدد خودتان را از صد نمونهٔ واقعی بگیرید.
- دادهٔ حساس را در متن نفرستید. شماره کارت و کد ملی برای دستهبندی لازم نیست؛ پیش از ارسال حذفشان کنید.
پرسش و تجربه کاربران
اگر این راهنما جوابتان را نداد، همینجا بپرسید. پرسشها را تیمملی ایپیآی پاسخ میدهد و هر نظر پیش از انتشار بررسی میشود.
هنوز پرسشی ثبت نشده، اولین نفر باشید.