تحلیل سند بلند فارسی با Claude Sonnet
متن را خودتان از فایل بیرون بکشید، یکجا بدهید و جواب ساختاریافته با نقلقول بخواهید. این راهنما مسیر را با API نشان میدهد و میگوید نقلقولها را چطور با سند تطبیق دهید.
برای تحلیل سند بلند فارسی، متن را خودتان از فایل بیرون بکشید، یکجا به مدل بدهید و از او جواب ساختاریافته با نقلقول بخواهید. این راهنما همین مسیر را با Claude Sonnet نشان میدهد و نمیگوید «فایل PDF را بفرستید»؛ ورودی این API متن و تصویر است و کنترل متن در دست خودتان بهتر است.
قدم اول: متن را خودتان استخراج کنید
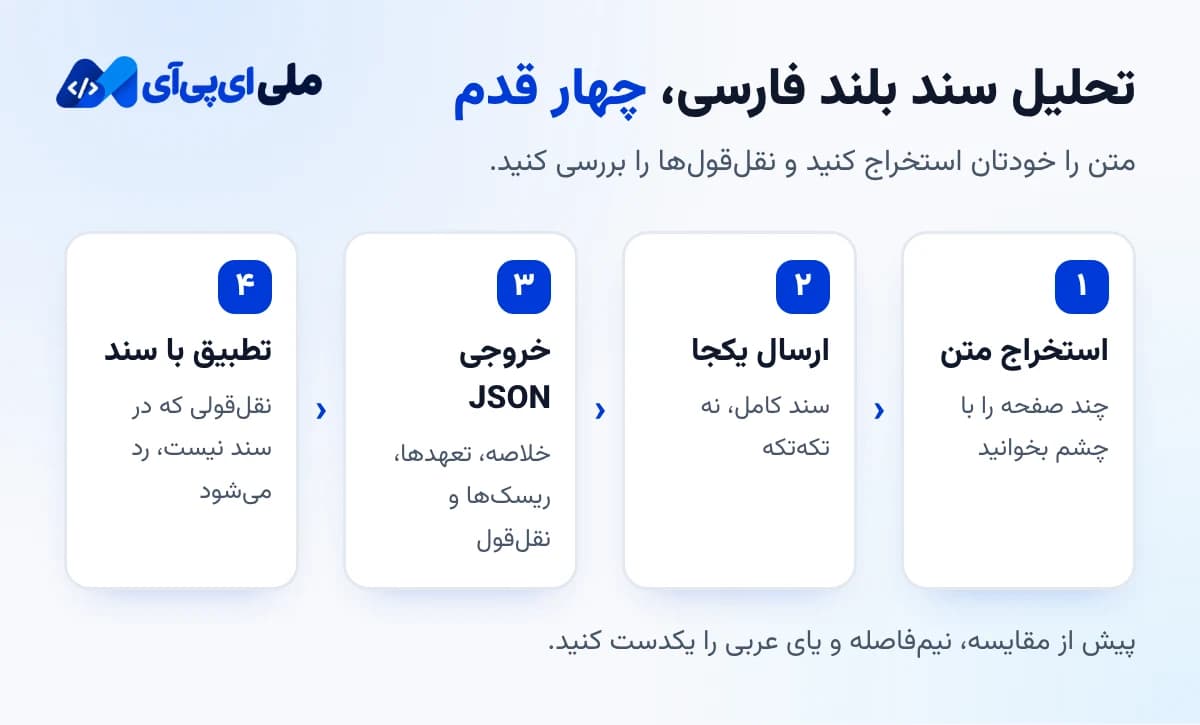
از PDF متن بگیرید و پیش از ارسال نگاهش کنید. فارسی در PDF بیشتر از هر زبان دیگری خراب استخراج میشود: حروف جدا، ترتیب معکوس، یا ارقام بههمریخته. چند صفحه را با چشم بخوانید. اگر متن خراب بود، مدل هم روی همان متن خراب کار میکند و جواب خوب نمیدهد. برای سند اسکنشده، متن را با یک ابزار تشخیص نوشته بگیرید و باز بررسی کنید.
قدم دوم: سند را یکجا بدهید، تکهتکه نه
اگر سند در پنجرهٔ مدل جا میشود، کامل بفرستید. تکهتکه کردن سؤالهایی را خراب میکند که جوابشان از ترکیب دو بخش درمیآید. برای اندازهگیری، تعداد نویسههای فارسی را تقریباً برابر تعداد توکن بگیرید، نه تعداد صفحه. سندی که انگلیسیاش راحت جا میشد، فارسیاش ممکن است نصف پنجره را بگیرد.
قدم سوم: قالب خروجی ثابت بخواهید
import json, os, requests
URL = "https://melliapi.net/api/v1/ai/chat/completions/"
SYSTEM = (
"سند زیر را بخوان و فقط JSON بده با این کلیدها: "
"summary (حداکثر سه جمله)، obligations (آرایهٔ تعهدها)، "
"risks (آرایه)، quotes (برای هر مورد، جملهٔ دقیق از سند). "
"هر ادعا را با نقلقول همان بخش از سند بیاور. "
"اگر موردی در سند نیست، آرایهٔ خالی بده و حدس نزن."
)
def analyze(text):
r = requests.post(
URL,
headers={"Authorization": "Bearer " + os.environ["MELLIAPI_API_KEY"]},
json={
"model": "anthropic-claude-sonnet-5.5",
"max_tokens": 2000,
"temperature": 0.2,
"messages": [
{"role": "system", "content": SYSTEM},
{"role": "user", "content": text},
],
},
timeout=180,
)
data = r.json()
if not data.get("ok"):
raise RuntimeError(data["error"]["code"])
return json.loads(data["content"])قدم چهارم: نقلقولها را بررسی کنید
مهمترین قدم این است. هر نقلقولی که مدل برگرداند، باید عیناً در متن سند باشد. با یک جستوجوی ساده بررسی کنید و موردی را که پیدا نشد، بیاعتبار بدانید.
def verified(result, source):
    return [q for q in result["quotes"] if q in source]
این بررسی ارزان است و جلوی بدترین خطا را میگیرد: جملهای که مدل ساخته و به سند نسبت داده است. نقلقول فارسی ممکن است در نیمفاصله یا یای عربی با متن اصلی فرق کند؛ پیش از مقایسه، هر دو متن را یکدست کنید.
زمان و هزینه
سند بلند پاسخ دیرتر میدهد. مهلت اتصال را دستکم چند دقیقه بگذارید و max_tokens را متناسب با خروجی بخواهید، نه بیشتر؛ سقف هزینه از همین عدد رزرو میشود. برای گفتوگوی چندمرحلهای دربارهٔ همان سند، متن کامل در هر پیام دوباره شمرده میشود، پس بعد از چند سؤال، خلاصهٔ سند را جای متن کامل بفرستید.
آنچه این روش انجام نمیدهد
- جای مشاور حقوقی را نمیگیرد. خروجی یک تحلیل اولیه برای مرور سریع است. تصمیم دربارهٔ تعهدهای قرارداد با شما و متخصص آن حوزه است.
- متن خراب را درست نمیکند. اگر استخراج متن ناقص بود، تحلیل هم ناقص میشود.
- سند حساس را بیملاحظه نفرستید. نام، شماره ملی و شماره حساب را اگر برای تحلیل لازم نیست، پیش از ارسال حذف کنید.
پرسش و تجربه کاربران
اگر این راهنما جوابتان را نداد، همینجا بپرسید. پرسشها را تیمملی ایپیآی پاسخ میدهد و هر نظر پیش از انتشار بررسی میشود.
هنوز پرسشی ثبت نشده، اولین نفر باشید.